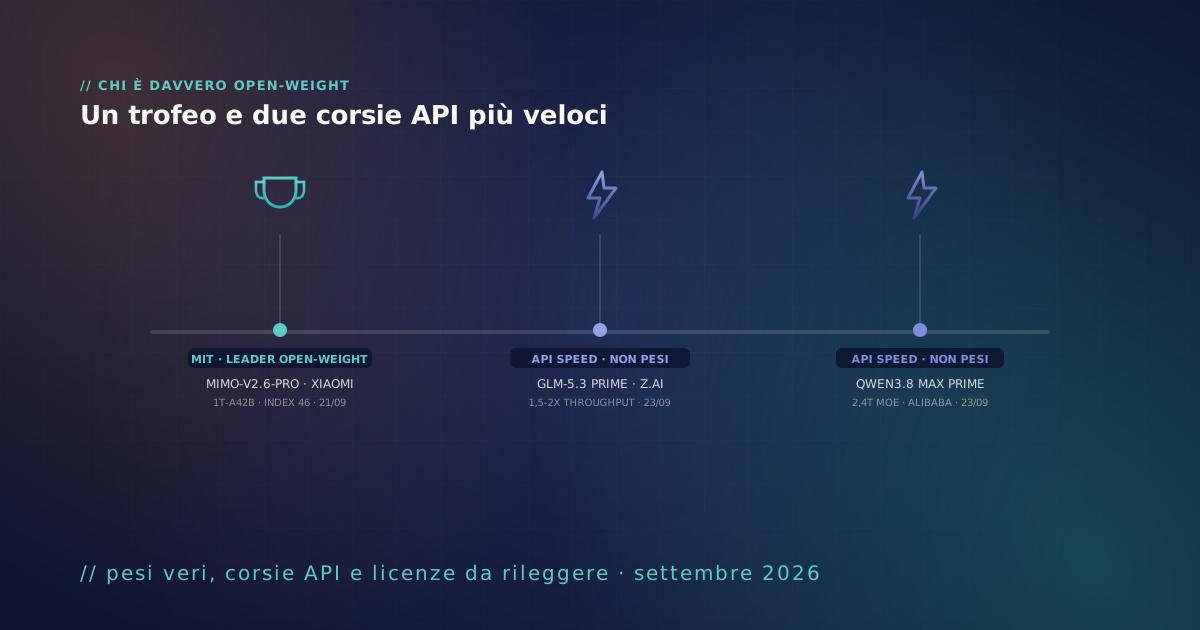
Les titres de cette semaine ne parlaient que de deux lancements partageant le même suffixe — "Prime" — l'un chez Z.ai, l'autre chez Alibaba. Aucun des deux, pourtant, n'est une publication de nouveaux poids : ce sont simplement des voies API plus rapides pour des modèles qui existaient déjà. La vraie nouvelle open-weight de la semaine, passée beaucoup plus inaperçue, est qu'un fabricant de smartphones vient de dépasser tous les laboratoires d'IA chinois les plus connus en tête du classement des modèles à poids publics.
MiMo-V2.6-Pro : Xiaomi prend la tête du classement open-weight
Le 21 septembre 2026, Xiaomi a publié sur Hugging Face MiMo-V2.6-Pro, un modèle Mixture-of-Experts épars comptant 1,02 billion de paramètres au total, dont seulement 42 milliards actifs par token, sous licence MIT pure — usage commercial libre, aucun seuil, aucune clause cachée. Selon Artificial Analysis, le modèle obtient 46 points sur l'Intelligence Index, le score le plus élevé jamais atteint par un modèle open-weight : il dépasse à la fois GLM-5.3 de Z.ai et Kimi K3 de Moonshot, tous deux bloqués à 44 points, et se classe sixième au classement général, modèles fermés inclus. Le détail qui a le plus surpris les observateurs est le coût d'entraînement annoncé — environ 3 millions de dollars — bien inférieur à ce qu'on associe habituellement à un modèle de cette taille, avec un rapport qualité-prix qu'Artificial Analysis place sur la frontière de Pareto entre intelligence et coût par token. Xiaomi a publié en parallèle MiMo-V2.6-Flash, une variante moins coûteuse pensée pour des volumes plus importants.
GLM-5.3 Prime et Qwen3.8 Max Prime : deux lancements qui ne sont pas de nouveaux poids
Le 23 septembre 2026, Z.ai a lancé GLM-5.3 Prime, une variante à haute vitesse de GLM-5.3 qui hérite de toutes les capacités du modèle de base mais délivre 1,5 à 2 fois le débit grâce à une accélération de l'inférence, avec un contexte allant jusqu'à 1 million de tokens et un raisonnement toujours activé — impossible à désactiver, avec trois niveaux d'effort (faible, élevé, maximal, ce dernier par défaut). Ce n'est pas un nouveau checkpoint : c'est un produit API, facturé 2,80 $ par million de tokens en entrée et 8,80 $ en sortie, pensé pour les charges de travail de codage et d'orchestration agentique à long horizon.
Le même jour, après l'annonce du 22 septembre à la Yunqi Conference de Hangzhou, Alibaba a activé Qwen3.8 Max Prime, une voie plus rapide du même Qwen3.8-Max — le modèle MoE épars de 2,4 billions de paramètres devenu, le 13 août, le premier modèle de classe "Max" de la famille Qwen à être publié en open-weight, sous licence Apache 2.0. Qwen3.8 Max Prime utilise les mêmes poids, la même fenêtre de contexte d'1 million de tokens et les mêmes outils que le modèle de base : seuls la vitesse et le prix changent, ce dernier doublant par rapport à la version standard (4 $ contre 2 $ par million de tokens en entrée, 12 $ contre 6 $ en sortie). Là encore, aucun nouveau poids à télécharger.
La licence de GLM-5.3 n'est pas une MIT : la clause qui compte pour les gros chiffres d'affaires
Il vaut la peine de revenir sur la licence du modèle de base GLM-5.3 (753 milliards de paramètres, publié sur Hugging Face le 28 août), car ce cas démontre une fois de plus à quel point il est risqué de se fier à l'étiquette. Z.ai n'a utilisé ni MIT ni Apache 2.0, mais un document sur mesure — la "GLM-5.3 License" — qui accorde en substance les mêmes droits qu'une licence MIT (utilisation, copie, modification, distribution, sous-licence, vente, incluant explicitement les poids, les paramètres, les fichiers de configuration ainsi que le code d'entraînement et d'inférence), avec une clause supplémentaire qui fait la différence : les opérateurs de Model-as-a-Service dépassant un certain seuil de chiffre d'affaires doivent se soumettre à un audit de sécurité. Deux jours plus tôt, le même laboratoire avait au contraire publié GLM-5.3-Flash — 320 milliards de paramètres au total, 18 milliards actifs, le premier modèle nativement multimodal (texte, image, vidéo) de la série GLM-5 — sous licence MIT pure et non modifiée, sans cette clause. Même laboratoire, même semaine, deux licences différentes pour deux modèles de la même famille.
Ce qui compte vraiment pour qui évalue une architecture IA aujourd'hui
- Un nom se terminant par "Prime", "Turbo" ou "Speed" désigne souvent une simple voie API plus rapide, et non un nouveau checkpoint téléchargeable : vérifiez toujours qu'un dépôt de poids existe réellement avant d'en parler comme d'une publication ouverte.
- Le classement des modèles open-weight change rapidement de mains — cette semaine, c'est un fabricant d'électronique grand public, et non l'un des laboratoires d'IA les plus connus, qui le mène : ne liez pas une architecture au classement d'un seul mois.
- Même au sein d'une même famille de modèles, les licences peuvent différer substantiellement : le modèle phare GLM-5.3 impose un audit de sécurité au-delà d'un seuil de chiffre d'affaires, GLM-5.3-Flash non. Il faut lire chaque publication individuellement, pas seulement l'étiquette de la famille.
- Un coût d'entraînement annoncé bien plus bas, comme pour MiMo-V2.6-Pro, ne dit rien de la qualité pour votre cas d'usage spécifique : il faut toujours le vérifier par un test réel, pas par le budget de développement du fournisseur.
C'est exactement le travail que nous faisons chaque semaine avec nos clients : distinguer une vraie publication de poids d'une nouvelle voie API portant le même nom de modèle, lire la licence exacte de chaque publication — pas celle de la précédente — et construire une architecture où le bon modèle tourne là où il doit tourner, avec vos données qui restent les vôtres, quel que soit le laboratoire qui a entraîné le modèle ou le classement qu'il mène cette semaine.
- VentureBeat — "Better than DeepSeek": Xiaomi's MiMo-V2.6-Pro debuts as the top open weights model in the world ↗
- Artificial Analysis — fiche du modèle MiMo-V2.6-Pro ↗
- Latent Space (AINews) — "Xiaomi MiMo-V2.6-Pro 1T-A42B: the new top Open Weights model, trained for $3M" ↗
- OpenRouter — GLM 5.3 Prime, spécifications et tarifs ↗
- Digital Applied — "GLM-5.3's Weights Are Out. The Licence Is Not MIT" ↗
- Hugging Face — zai-org/GLM-5.3-Flash, texte de la licence MIT ↗
- OpenRouter — Qwen3.8 Max Prime, spécifications et tarifs ↗
- Eigent — "Qwen3.8-Max: Alibaba's 2.4T Open-Weight Coding Model" ↗