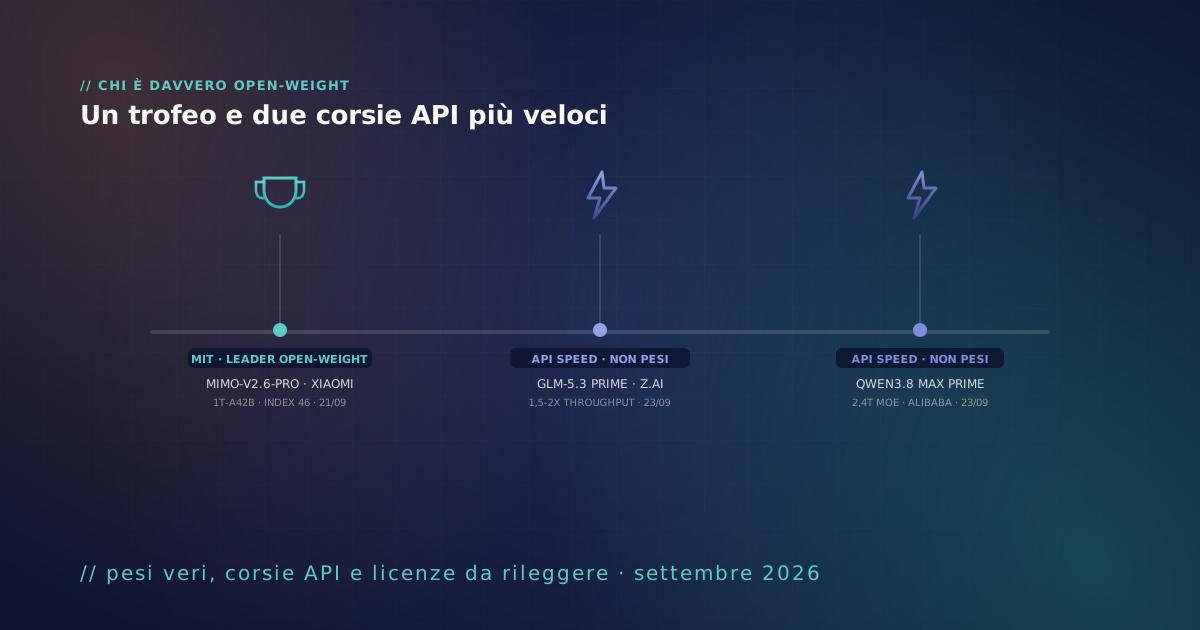
Questa settimana i titoli erano tutti per due lanci con lo stesso suffisso — "Prime" — uno di Z.ai e uno di Alibaba. Nessuno dei due, però, è un rilascio di nuovi pesi: sono corsie API più veloci di modelli già esistenti. La vera notizia open-weight della settimana, arrivata con molto meno clamore, è che un produttore di smartphone ha appena scavalcato tutti i laboratori AI cinesi più noti in cima alla classifica dei modelli con pesi pubblici.
MiMo-V2.6-Pro: Xiaomi in cima alla classifica open-weight
Il 21 settembre 2026 Xiaomi ha pubblicato su Hugging Face MiMo-V2.6-Pro, un modello Mixture-of-Experts sparso da 1,02 trilioni di parametri totali, di cui solo 42 miliardi attivi per token, sotto licenza MIT pura — uso commerciale libero, nessuna soglia, nessuna clausola nascosta. Secondo Artificial Analysis, il modello segna 46 punti sull'Intelligence Index, il punteggio più alto mai raggiunto da un modello open-weight: supera sia GLM-5.3 di Z.ai sia Kimi K3 di Moonshot, entrambi fermi a 44, e si piazza sesto in classifica assoluta contando anche i modelli chiusi. Il dettaglio che ha sorpreso di più gli osservatori è il costo di addestramento dichiarato — circa 3 milioni di dollari — molto più basso di quanto normalmente associato a un modello di questa taglia, con un rapporto qualità-prezzo che Artificial Analysis colloca sulla frontiera di Pareto tra intelligenza e costo per token. Xiaomi ha pubblicato in parallelo anche MiMo-V2.6-Flash, una variante più economica pensata per volumi più alti.
GLM-5.3 Prime e Qwen3.8 Max Prime: due lanci che non sono nuovi pesi
Il 23 settembre 2026 Z.ai ha lanciato GLM-5.3 Prime, una variante ad alta velocità di GLM-5.3 che eredita tutte le capacità del modello base ma eroga 1,5-2 volte il throughput grazie a un'accelerazione dell'inferenza, con contesto fino a 1 milione di token e reasoning sempre attivo — non disattivabile, con tre livelli di sforzo (basso, alto, massimo, quest'ultimo di default). Non è un checkpoint nuovo: è un prodotto API, prezzato 2,80 $ per milione di token in input e 8,80 $ in output, pensato per workload di coding e orchestrazione agentica a lungo orizzonte.
Lo stesso giorno, dopo l'annuncio del 22 settembre alla Yunqi Conference di Hangzhou, Alibaba ha attivato Qwen3.8 Max Prime, una corsia più veloce dello stesso Qwen3.8-Max — il modello MoE sparso da 2,4 trilioni di parametri diventato, il 13 agosto, il primo modello di classe "Max" della famiglia Qwen a essere reso open-weight, sotto Apache 2.0. Qwen3.8 Max Prime usa gli stessi pesi, la stessa finestra di contesto da 1 milione di token e gli stessi strumenti del modello base: cambiano solo velocità e prezzo, che raddoppia rispetto alla versione standard (4 $ contro 2 $ per milione di token in input, 12 $ contro 6 $ in output). Anche qui, nessun peso nuovo da scaricare.
La licenza di GLM-5.3 non è MIT: la clausola che conta per chi fattura molto
Vale la pena tornare sulla licenza del modello base GLM-5.3 (753 miliardi di parametri, pubblicato su Hugging Face il 28 agosto), perché è un caso che dimostra ancora una volta quanto sia rischioso fidarsi dell'etichetta. Z.ai non ha usato MIT o Apache 2.0, ma un documento su misura — la "GLM-5.3 License" — che nella sostanza concede gli stessi diritti di una MIT (uso, copia, modifica, distribuzione, sublicenza, vendita, inclusi pesi, parametri, file di configurazione e codice di addestramento e inferenza), con un'unica clausola aggiuntiva che fa la differenza: gli operatori Model-as-a-Service che superano una determinata soglia di fatturato devono sottoporsi a una verifica di sicurezza. Due giorni prima, lo stesso laboratorio aveva invece rilasciato GLM-5.3-Flash — 320 miliardi di parametri totali, 18 attivi, il primo modello nativamente multimodale (testo, immagini, video) della serie GLM-5 — sotto licenza MIT pura, senza quella clausola. Stesso laboratorio, stessa settimana, due licenze diverse per due modelli della stessa famiglia.
Cosa conta per chi valuta un'architettura AI oggi
- Un nome che finisce in "Prime", "Turbo" o "Speed" spesso indica solo una corsia API più veloce, non un nuovo checkpoint scaricabile: verificate sempre se esiste un repository di pesi prima di parlarne come di un rilascio open.
- La classifica dei modelli open-weight cambia mano rapidamente — questa settimana a guidarla è un produttore di elettronica di consumo, non uno dei laboratori AI più noti: non vincolate un'architettura a un solo mese di classifica.
- Anche dentro la stessa famiglia di modelli le licenze possono differire in modo sostanziale: GLM-5.3 flagship impone una verifica di sicurezza oltre una soglia di fatturato, GLM-5.3-Flash no. Va letta ogni singola release, non la famiglia nel suo insieme.
- Un costo di addestramento dichiarato molto più basso, come nel caso di MiMo-V2.6-Pro, non dice nulla sulla qualità per il vostro caso d'uso specifico: va sempre verificato con un test reale, non con il budget di sviluppo del fornitore.
È il lavoro che facciamo ogni settimana con i nostri clienti: distinguere un vero rilascio di pesi da una nuova corsia API con lo stesso nome del modello, leggere la licenza esatta di ogni release — non quella della release precedente — e costruire un'architettura dove il modello giusto gira dove deve girare, con i vostri dati che restano vostri, indipendentemente da quale laboratorio abbia addestrato il modello o da quale classifica guidi questa settimana.
- VentureBeat — "Better than DeepSeek": Xiaomi's MiMo-V2.6-Pro debuts as the top open weights model in the world ↗
- Artificial Analysis — scheda del modello MiMo-V2.6-Pro ↗
- Latent Space (AINews) — "Xiaomi MiMo-V2.6-Pro 1T-A42B: the new top Open Weights model, trained for $3M" ↗
- OpenRouter — GLM 5.3 Prime, specifiche e prezzi ↗
- Digital Applied — "GLM-5.3's Weights Are Out. The Licence Is Not MIT" ↗
- Hugging Face — zai-org/GLM-5.3-Flash, testo della licenza MIT ↗
- OpenRouter — Qwen3.8 Max Prime, specifiche e prezzi ↗
- Eigent — "Qwen3.8-Max: Alibaba's 2.4T Open-Weight Coding Model" ↗