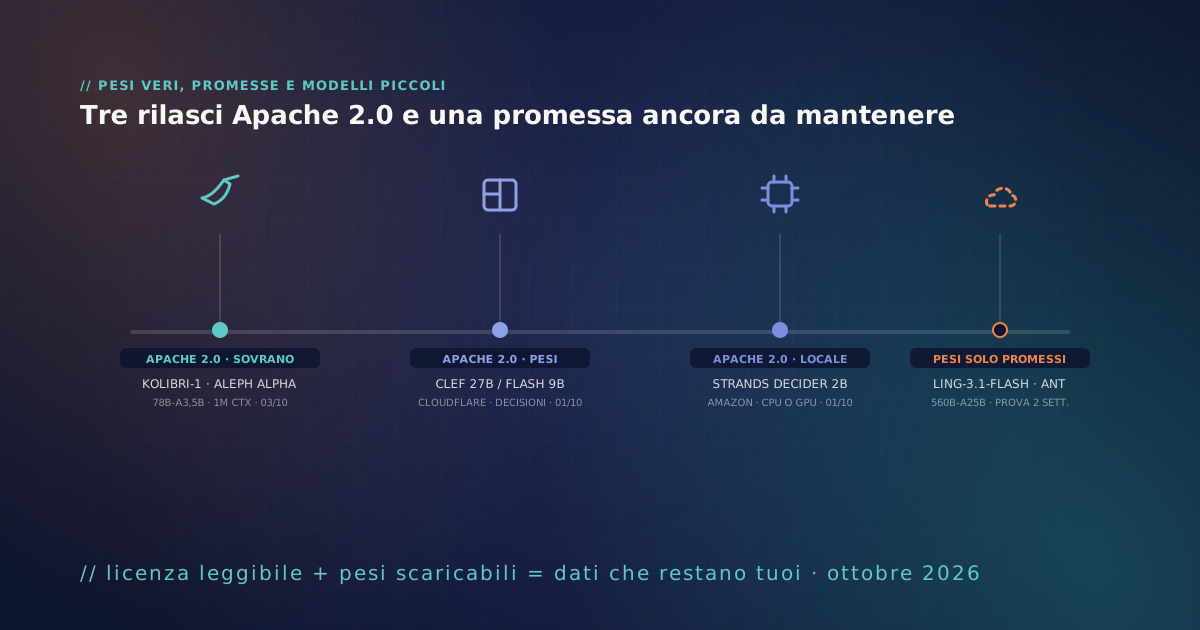
Après une semaine d'annonces bruyantes, les premiers jours d'octobre 2026 apportent des publications open-weight plus discrètes mais bien plus utiles pour qui doit bâtir une architecture IA conforme : un modèle européen avec poids complets, deux familles de modèles « décisionnels » conçues pour les agents, un modèle de traduction, et une grande annonce qui, pour l'instant, ne comprend aucun poids téléchargeable.
Kolibri-1 : le modèle souverain d'Aleph Alpha, avec poids Apache 2.0
Le 3 octobre 2026, Aleph Alpha a publié sur Hugging Face Kolibri-1, un modèle Mixture-of-Experts de 78,1 milliards de paramètres au total et 3,46 milliards actifs par token, bilingue anglais et allemand, sous licence Apache 2.0. Le contexte atteint environ un million de tokens (entraîné jusqu'à 256k, étendu à 1M par configuration), avec mode de raisonnement et appel d'outils. L'entreprise affirme l'avoir développé en Allemagne, entraîné sur des infrastructures en Allemagne et en Finlande, sous droit européen et allemand, sans contrôle étranger, sur environ 20 000 milliards de tokens dont environ 4 300 milliards en allemand. Avec seulement 3,46 milliards de paramètres actifs, elle indique qu'il peut servir 18 requêtes concurrentes de 256k tokens sur deux GPU H100 : une taille à la portée d'une infrastructure sur site ou d'un cloud souverain suisse. Les poids sont disponibles en FP8 et BF16.
Cloudflare Clef et Amazon Strands Decider : des modèles qui renvoient des probabilités, pas du texte
Le 1er octobre, Cloudflare a publié Clef (27B) et Clef-flash (9B), avec poids sur Hugging Face sous Apache 2.0, également disponibles sur Workers AI. Ce sont des « modèles décisionnels » : ils reçoivent un état et un ensemble de questions typées et renvoient une probabilité pour chaque réponse autorisée, afin qu'un agent puisse router un ticket, bloquer une requête ou passer la main à une personne de manière vérifiable. Le même jour, Amazon a publié Strands Decider 2B, un modèle décisionnel de 2 milliards de paramètres exécutable en local sur CPU ou GPU, avec poids, données d'entraînement et scripts, lui aussi sous Apache 2.0. Pour la conformité, l'intérêt est concret : une décision avec probabilités explicites est bien plus simple à journaliser et à auditer qu'un texte libre.
Index-Translate-35B-A3B : traduction en 150 langues, encore en préversion
Le 2 octobre, l'équipe Index de Bilibili a publié en préversion Index-Translate-35B-A3B, un MoE de 35 milliards de paramètres au total et 3 actifs, avec un contexte de 262 144 tokens et la prise en charge de 150 langues de texte, sous Apache 2.0. Les versions denses de 2B et 9B étaient déjà sur Hugging Face depuis le 28 septembre. S'agissant d'une préversion, il faut l'évaluer sur vos propres documents avant tout usage en production.
Ling-3.1-flash : une promesse de poids n'est pas une publication
InclusionAI, la division d'Ant Group, a présenté entre fin septembre et début octobre Ling-3.1-flash, un modèle de 560 milliards de paramètres au total et environ 25 actifs, destiné aux agents, à la recherche et aux applications bureautiques, avec un contexte conçu pour atteindre un million de tokens (limité à 256k pendant l'essai gratuit de deux semaines). InclusionAI déclare vouloir le publier en open source après l'essai. Tant que les poids ne sont pas sur un dépôt avec une licence lisible, cependant, pour une entreprise qui doit garantir où tournent ses données, c'est un service API, pas un modèle ouvert.
Ce qui compte vraiment si vous évaluez une architecture IA aujourd'hui
- « L'open source arrive » n'est pas « open-weight » : tant qu'il n'existe ni poids téléchargeables ni licence lisible, le modèle ne peut pas faire partie d'une architecture qui garantit la propriété des données.
- Les petits modèles spécialisés, comme les modèles décisionnels ou de traduction, sont souvent le moyen le plus simple de garder les données sensibles en interne : ils tournent sur un seul GPU, voire sur CPU.
- La provenance compte : un modèle à chaîne d'approvisionnement déclarée, entraîné en Europe et sous Apache 2.0, comme Kolibri-1, simplifie la documentation exigée par la nLPD et le RGPD, mais doit quand même être validé sur votre cas d'usage.
- Les préversions ne sont pas des produits : testez toujours les modèles sur vos documents réels avant de fonder un processus sur le benchmark d'un fournisseur.
C'est le travail que nous faisons chaque semaine avec nos clients : distinguer les poids réellement téléchargeables des annonces, lire la licence de chaque publication et construire une architecture où le bon modèle tourne là où il doit tourner, avec vos données qui restent les vôtres.
- Aleph Alpha — Kolibri has landed: a sovereign open-weight model ↗
- Hugging Face — Aleph-Alpha/Kolibri-1 (Apache 2.0) ↗
- Startup Fortune — Aleph Alpha puts Kolibri's full weights on Hugging Face under Apache 2.0 ↗
- Cloudflare Changelog — Introducing Clef: Cloudflare's first open-source decision models ↗
- MarkTechPost — Cloudflare Releases Clef and Clef-flash ↗
- Digital Applied — AI Model Releases: October 2026 Tracker ↗
- TechNode — Ant Group launches Ling-3.1-flash with 560 billion parameters ↗
- Artificial Analysis — Ling 3.1 Flash ↗