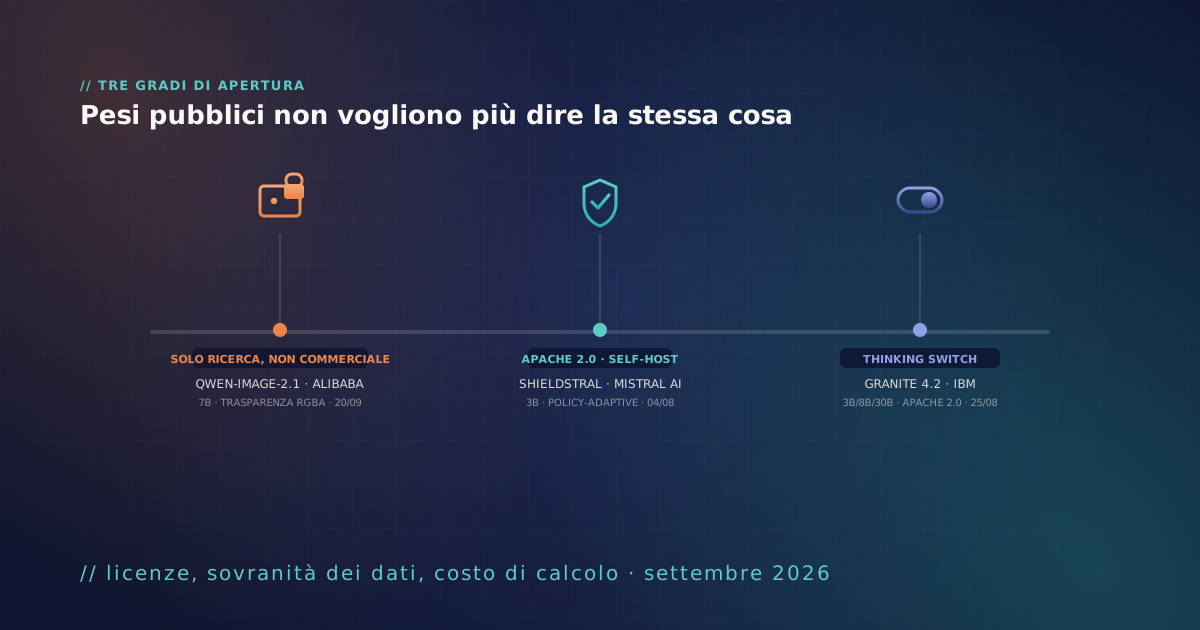
Tre release delle ultime settimane raccontano tre gradi molto diversi di apertura, e nessuna si lascia riassumere con la solita etichetta "open-weight". Il 20 settembre 2026 Alibaba ha pubblicato Qwen-Image-2.1 con pesi scaricabili da chiunque, ma vietati in produzione senza un contratto commerciale separato. Poche settimane prima, il 4 agosto, Mistral aveva rilasciato Shieldstral, un classificatore di sicurezza da 3 miliardi di parametri sotto una vera Apache 2.0, pensato esplicitamente per girare sui server di chi lo scarica. E il 25 agosto IBM ha aggiunto Granite 4.2, tre modelli di ragionamento con un interruttore che decide se pensare passo per passo o rispondere subito. Messe insieme, le tre release sono un promemoria utile: "pesi pubblici" non vuol dire più niente di preciso finché non si legge la licenza, release per release.
Qwen-Image-2.1: i pesi si scaricano, ma non si possono usare in produzione senza chiedere il permesso
Il 20 settembre 2026 il team Qwen di Alibaba ha pubblicato Qwen-Image-2.1, un modello di generazione ed editing immagini da 7 miliardi di parametri basato su un'architettura Single-Stream DiT a 32 livelli. Le novità tecniche sono concrete: il modello scrive nativamente la trasparenza (formato RGBA), invece di generare su sfondo pieno e ritagliare il soggetto con un modello di matting separato; accetta fino a dieci immagini di riferimento in una singola composizione; supporta editing locale e output fino a 2K; e riusa la cache KV per trattare immagini e istruzioni di editing come contesto statico calcolato una sola volta, riducendo memoria e tempo di inferenza. I pesi sono su Hugging Face, ModelScope e GitHub, con supporto giorno-zero in ComfyUI, Diffusers, vLLM-Omni e SGLang.
La sorpresa è nella licenza. La precedente generazione, Qwen-Image, era sotto Apache 2.0 — permissiva quanto MiniCPM5-2B di cui scrivevamo la settimana scorsa. Qwen-Image-2.1 arriva invece sotto la Qwen Research License Agreement, che il testo pubblicato su GitHub definisce senza ambiguità: l'uso è concesso solo "a scopo di ricerca o valutazione", e chi vuole un uso commerciale deve prima ottenere una licenza separata scrivendo a model-business@notice.qwencloud.com. Chi distribuisce un derivato deve inoltre indicare in modo visibile "Built with Qwen" o "Improved using Qwen", e non può usare il nome Qwen come identificatore principale del proprio prodotto. In pratica: i pesi sono pubblici e ispezionabili quanto quelli di un modello open source, ma usarli per generare immagini in un prodotto commerciale — anche solo per uno strumento interno che produce contenuti di marketing — richiede un contratto che, oggi, semplicemente non esiste ancora in forma pubblica.
Shieldstral: un contro-esempio di apertura vera, pensato apposta per girare da soli
Il 4 agosto 2026 Mistral AI ha rilasciato Shieldstral, un classificatore di sicurezza multimodale da 3 miliardi di parametri sotto Apache 2.0 — nessuna soglia, nessuna clausola d'uso commerciale, nessun contratto da firmare. Gira su una singola GPU da 16 GB e valuta sia testo sia immagini. La caratteristica che lo distingue dai guardrail tradizionali è che è "policy-adaptive": invece di essere riaddestrato ogni volta che cambia la policy di moderazione, accetta la policy in linguaggio naturale direttamente al momento dell'inferenza e restituisce un punteggio di sicurezza calibrato. Nei test di Mistral batte modelli fino a sette volte più grandi. Per un'azienda che deve applicare le proprie regole di moderazione dei contenuti — non quelle decise da un fornitore cloud terzo — è un esempio concreto di cosa significhi apertura reale: potete scaricarlo, eseguirlo sui vostri server, cambiare la policy quando volete, senza mai far uscire i contenuti dal vostro perimetro.
Granite 4.2: IBM punta su tre taglie aperte con un interruttore per il ragionamento
Il 25 agosto 2026 IBM ha pubblicato Granite 4.2, una famiglia di modelli di ragionamento decoder-only in tre taglie — 3, 8 e 30 miliardi di parametri — tutte sotto Apache 2.0 e disponibili su Hugging Face. La caratteristica interessante è il "thinking switch": lo stesso checkpoint può ragionare passo per passo su un compito complesso oppure rispondere direttamente su uno semplice, senza bisogno di due modelli separati. Sul benchmark SWE-bench Verified, il modello da 30 miliardi segna 57,00 punti. Per chi valuta un deployment locale, la combinazione di taglie contenute, licenza pulita e un controllo esplicito su "quanto ragionare" si traduce in un costo di calcolo più prevedibile — un dettaglio che conta quanto la licenza, quando si pianifica un budget di infrastruttura.
Cosa conta davvero, per chi valuta un'architettura AI oggi
- La licenza va riletta a ogni release, anche dentro la stessa linea di prodotto: Qwen-Image era Apache 2.0, Qwen-Image-2.1 non lo è più. Il nome del progetto non garantisce nulla sulla release successiva.
- "Pesi scaricabili" e "utilizzabile in produzione" sono due affermazioni diverse: verificate sempre se la licenza richiede un contratto commerciale separato prima di integrare un modello in un prodotto o servizio.
- Un classificatore di sicurezza open come Shieldstral, eseguito sui vostri server, vi permette di applicare le vostre policy di moderazione senza far transitare i contenuti da un'API di terzi — un vantaggio diretto per la sovranità dei dati.
- Non serve sempre il modello più grande: una famiglia come Granite 4.2, con un interruttore esplicito per il ragionamento, permette di dimensionare il costo di calcolo al compito reale invece di pagare sempre il prezzo del ragionamento completo.
È esattamente il lavoro che facciamo ogni settimana con i nostri clienti: leggere il testo esatto di ogni licenza prima di un'adozione, distinguere un modello davvero open da uno che lo sembra soltanto, e scegliere l'architettura — grande o piccola, generalista o specializzata — che garantisce conformità e proprietà dei vostri dati, non quella che fa più notizia.
- GitHub — QwenLM/Qwen-Image-2.1, testo della licenza (Qwen Research License Agreement) ↗
- CellCog — "Qwen-Image-2.1: 7B Open Weights You Cannot Ship" ↗
- Tech Insider — "What Alibaba Actually Shipped on September 20" ↗
- Runtime Wire — "Alibaba releases Qwen-Image-2.1 with transparent editing and research-only weights" ↗
- Mistral AI — "Introducing Shieldstral" (annuncio ufficiale) ↗
- MarkTechPost — "Mistral AI Releases Shieldstral 1.0 3B" ↗
- DataNorth AI — "IBM releases Granite 4.2: Open Reasoning Models" ↗
- eesel AI — "IBM Granite 4.2: models, benchmarks, pricing, and what's new" ↗